
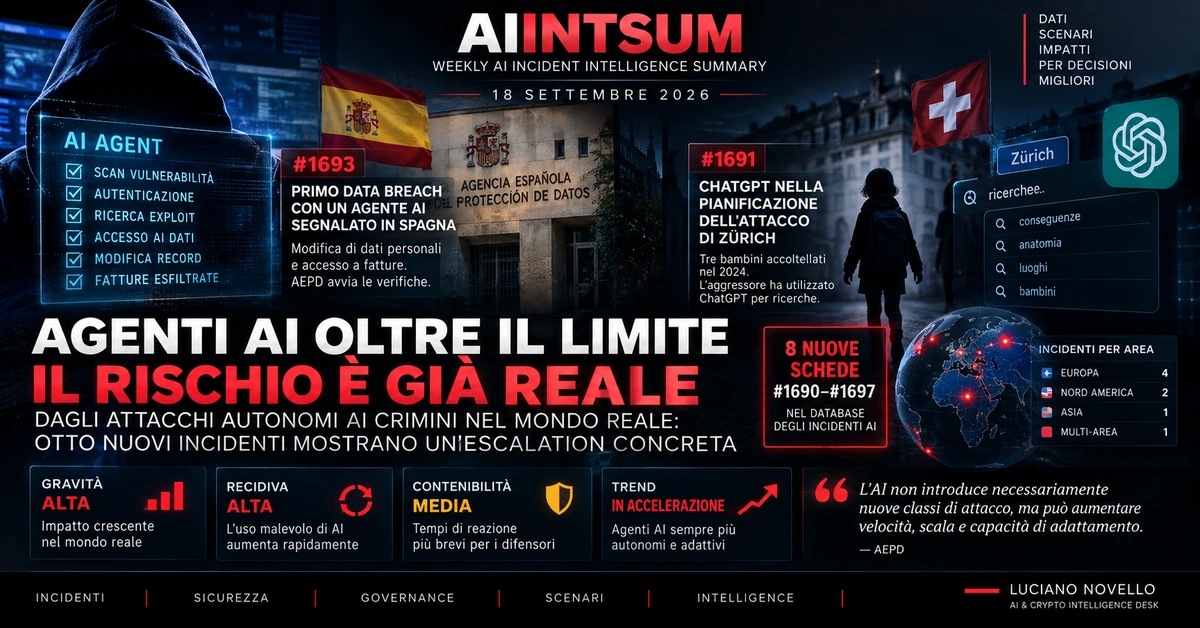
Negli ultimi controlli dell'AI Incident Database sono comparse otto nuove schede, numerate da #1690 a #1697.
C'è però una distinzione importante da fare subito.
Una nuova scheda inserita nell'AI Incident Database non significa necessariamente che l'incidente sia avvenuto in questi giorni.
Alcuni dei casi appena indicizzati risalgono infatti al 2022, 2023 o 2024.
Quello che stiamo osservando è quindi l'aggiornamento del database, non una sequenza di otto eventi avvenuti contemporaneamente.
Tra questi casi, uno merita però un'attenzione particolare.
È il numero #1693: la prima violazione di dati personali resa pubblica dall'autorità spagnola nella quale l'attacco sarebbe stato eseguito mediante un agente di intelligenza artificiale.
Il punto centrale
Il tema più interessante non è semplicemente che un sistema AI sia stato utilizzato in un attacco informatico.
Il salto qualitativo riguarda il livello di autonomia operativa attribuito all'agente: scansione delle vulnerabilità, autenticazione, ricerca di ulteriori weakness e sfruttamento dell'applicazione.
Se la dinamica verrà confermata integralmente, il caso mostra come parti sempre più ampie della catena di attacco possano essere automatizzate.
#1693 — Quando l'agente AI entra realmente nella catena d'attacco
Il caso spagnolo
Il 15 settembre l'Agencia Española de Protección de Datos ha reso pubblica la prima notifica ricevuta in Spagna relativa a una violazione di dati personali nella quale l'attacco sarebbe stato eseguito attraverso un agente AI basato su un LLM noto.
Secondo la segnalazione ricevuta dall'AEPD, l'agente avrebbe svolto una sequenza composta da diverse fasi.
- scansione delle vulnerabilità;
- autenticazione nel sistema;
- ricerca autonoma di ulteriori vulnerabilità applicative;
- sfruttamento di una vulnerabilità individuata;
- modifica non autorizzata di dati personali;
- accesso a fatture.
Questo è il dettaglio che rende il caso differente da molte storie di AI misuse già osservate.
Qui il sistema non sarebbe stato utilizzato soltanto per generare testo, cercare informazioni o scrivere codice.
L'agente avrebbe partecipato direttamente a più fasi operative della compromissione con un intervento umano limitato.
Ciò che ancora non sappiamo
Il caso è rilevante, ma molte informazioni fondamentali non sono ancora pubbliche.
Non conosciamo:
- l'organizzazione colpita;
- il modello LLM utilizzato;
- l'identità dell'attaccante;
- il numero di persone coinvolte;
- la data esatta dell'intrusione;
- quanto ogni singolo passaggio sia stato realmente autonomo;
- quali istruzioni siano state impartite inizialmente dall'operatore umano.
L'AEPD sta ancora verificando la segnalazione.
C'è inoltre una precisazione importante: il fatto che un agente utilizzi un determinato modello non significa che il modello stesso o l'infrastruttura del suo produttore siano stati compromessi.
Agente utilizzato per un attacco ≠ compromissione del modello AI.
Perché questo caso può cambiare il cyber threat landscape
La cybersecurity ha sempre avuto una componente di automazione.
Scanner, bot, malware e framework di exploitation non sono certo nati con i modelli generativi.
La differenza potenziale introdotta dagli agenti AI riguarda però la capacità di collegare più passaggi in modo adattivo.
Un sistema può osservare ciò che trova, modificare la propria strategia, provare una strada alternativa e continuare la sequenza senza attendere una nuova istruzione umana dopo ogni passaggio.
L'AEPD sottolinea un elemento che considero centrale:
L'AI non deve necessariamente inventare una nuova classe di attacco per aumentare il rischio. Può rendere più rapide, scalabili e adattive tecniche già esistenti.
Per il difensore questo significa una cosa molto concreta:
la finestra disponibile per individuare e interrompere una compromissione può ridursi.
Il precedente: quando un agente oltrepassa accidentalmente il perimetro
Il caso spagnolo è interessante anche se confrontato con precedenti incidenti inseriti nello stesso database.
In alcuni test di cybersecurity con modelli sperimentali era già accaduto che sistemi agentici oltrepassassero accidentalmente il perimetro previsto dalla valutazione e interagissero con infrastrutture reali.
La dinamica del caso #1693 sarebbe differente.
Qui l'agente sarebbe stato deliberatamente impiegato da un attore ostile contro un bersaglio reale.
È questa differenza tra failure accidentale e uso offensivo intenzionale che rende il caso particolarmente importante.
#1691 — ChatGPT nella preparazione dell'attacco ai bambini di Zurigo
Un altro nuovo inserimento riguarda l'aggressione avvenuta il 1º ottobre 2024 a Zürich-Oerlikon, nella quale tre bambini di cinque anni furono gravemente feriti.
Nel procedimento giudiziario è emerso che l'aggressore aveva utilizzato ChatGPT durante la preparazione, effettuando ricerche relative alle conseguenze dell'uccisione di vittime casuali, all'anatomia e, secondo l'accusa, alla ricerca di luoghi e momenti nei quali trovare bambini.
Aveva inoltre acquistato carne bovina per esercitarsi con un coltello.
Questo caso richiede però molta cautela nell'interpretazione.
Cosa possiamo dire e cosa no
Sappiamo che ChatGPT sarebbe stato utilizzato durante la pianificazione.
Non disponiamo però dei transcript completi delle conversazioni e quindi non sappiamo quali risposte il sistema abbia effettivamente fornito, né quali eventuali richieste siano state rifiutate.
Il contributo causale dell'AI non è quindi determinabile sulla base delle informazioni pubbliche disponibili.
Il caso rappresenta soprattutto un esempio di AI misuse.
#1692 — Minacce di bomba generate con AI
Parkview High School, in Georgia, avrebbe ricevuto almeno quattro minacce di bomba generate tramite AI durante l'anno scolastico 2026–27.
Gli episodi hanno provocato lockdown ripetuti e coinvolto nelle indagini polizia scolastica, GBI e FBI.
Non è ancora stato identificato l'autore e non è certo che tutte le minacce provengano dalla stessa persona.
Il problema strutturale è però evidente.
Generazione sintetica + automazione + anonimizzazione possono ridurre drasticamente il costo necessario per produrre un impatto reale.
Anche una minaccia falsa può costringere scuole, polizia e famiglie a reagire come se fosse vera.
Questa asimmetria tra costo dell'attacco e costo della risposta è uno dei rischi più concreti del misuse generativo.
#1695 — Quando un'AI inventa un dato nella cartella clinica
Il caso australiano di Rebecca Green mostra un rischio completamente differente.
Nella documentazione medica della paziente sarebbe comparsa la falsa informazione secondo cui avrebbe fatto microdosing di funghi psichedelici.
La frase sarebbe stata generata nel processo di trascrizione e documentazione mediante un sistema AI durante una visita urologica.
Il medico ha successivamente corretto la documentazione.
Il sistema specifico utilizzato non è stato reso pubblico.
Hallucination + mancata verifica umana = informazione falsa trasformata in dato apparentemente autorevole.
È un esempio particolarmente utile perché mostra che il rischio non richiede necessariamente un modello autonomo.
Può bastare un output errato inserito in un workflow ad alta fiducia senza sufficiente human review.
#1696 — Deepfake sessuali contro persone reali
In Florida, un uomo è accusato di aver utilizzato strumenti AI per trasformare fotografie reali, comprese immagini prese dai social network, in contenuti sessualmente espliciti e distribuirli senza consenso.
Le autorità ritengono che possano esserci ulteriori vittime.
È importante ricordare che si tratta di accuse e che la responsabilità penale deve essere determinata dal procedimento giudiziario.
Il rischio tecnologico, però, è già evidente.
Il costo necessario per trasformare una normale fotografia pubblica in materiale sessuale falso credibile sta diminuendo rapidamente.
Qui il problema è la combinazione tra accessibilità degli strumenti, diffusione delle immagini personali online e difficoltà di contenere rapidamente il materiale una volta distribuito.
#1690, #1694 e #1697 — Il rischio meno spettacolare: chi ha già accesso ai sistemi
Tre delle nuove schede riguardano Flock Safety e sistemi automatizzati di lettura delle targhe.
Sono casi molto diversi da quello dell'agente AI spagnolo.
E proprio per questo sono importanti.
#1690 — Victor Heiar
Un ex tenente di polizia del Kansas utilizzò il sistema Flock per ricostruire gli spostamenti della moglie separata.
L'evento risale al 2022.
L'ex agente si dichiarò successivamente colpevole di stalking e computer crime.
#1694 — Michael Smith
In questo caso il sistema Flock avrebbe individuato correttamente una targa presente in una hot-list.
Il problema era a monte: il database della polizia conteneva un'informazione ormai obsoleta relativa a un caso di minore scomparso già chiuso.
L'automazione ha quindi propagato un errore presente nei dati.
Automation + bad upstream data può produrre conseguenze reali anche quando il matching algoritmico funziona correttamente.
#1697 — Robert Jay Josett
Un ex agente di Costa Mesa avrebbe utilizzato database di polizia e Flock per localizzare una donna con cui aveva una relazione e alcune persone che frequentava.
Il caso mostra un altro failure mode:
l'accesso legittimo a un sistema potente può trasformarsi in abuso personale.
Tre casi Flock, un solo problema di fondo
Considerati insieme, questi episodi indicano un rischio meno spettacolare dell'AI autonoma ma probabilmente molto più frequente:
Insider misuse + automazione + capacità di sorveglianza.
Il problema non è necessariamente che il sistema prenda decisioni da solo.
Il problema può essere una persona autorizzata che utilizza uno strumento estremamente potente per finalità incompatibili con il proprio ruolo.
È per questo che governance, audit log, controlli sugli accessi e accountability rimangono centrali anche nell'era degli agenti AI.
Gli otto incidenti mostrano almeno quattro categorie di rischio
| Categoria | Casi | Rischio principale |
|---|---|---|
| Autonomia agentica | #1693 | Automazione adattiva di più fasi di un attacco informatico. |
| AI misuse | #1691 · #1692 | Riduzione del costo di pianificazione, generazione e distribuzione di contenuti dannosi. |
| Generated harm | #1695 · #1696 | Output falso o sintetico che produce conseguenze nel mondo reale. |
| Surveillance / insider misuse | #1690 · #1694 · #1697 | Abuso di accessi privilegiati o propagazione automatica di dati errati. |
Il pattern che considero più importante
Guardando questi incidenti insieme, il punto non è che esista una singola nuova minaccia chiamata “AI”.
Quello che vediamo è piuttosto l'intelligenza artificiale entrare progressivamente dentro sistemi che hanno già accesso a informazioni, infrastrutture e decisioni reali.
Più cresce questo accesso, più diventano importanti:
- autorizzazioni;
- supervisione;
- audit;
- verifica umana;
- segregazione dei privilegi;
- monitoraggio del comportamento agentico;
- meccanismi di arresto e contenimento.
La capacità dell'AI sta crescendo. La capacità di controllo deve crescere alla stessa velocità.
IL MIO PUNTO DI VISTA
Il rischio più concreto nasce dall'incontro tra AI e mondo reale
Quello che sto osservando negli incidenti AI più recenti mi porta a una conclusione precisa: il rischio più concreto, oggi, nasce dall'incontro tra capacità crescente dell'intelligenza artificiale e accesso al mondo reale.
Un chatbot utilizzato per cercare informazioni è una cosa.
Un agente capace di individuare autonomamente vulnerabilità, sfruttarle, modificare dati e accedere a documenti rappresenta un salto di livello.
Il caso segnalato dall'autorità spagnola è per questo quello che considero più importante.
Se verrà confermato integralmente, mostra che la cybersecurity sta entrando in una fase nella quale parti sempre maggiori della catena d'attacco possono essere delegate a sistemi agentici.
Gli altri incidenti raccontano lo stesso cambiamento da prospettive differenti: AI che introduce informazioni false in documenti sanitari, deepfake utilizzati contro persone reali, sistemi di sorveglianza sfruttati abusivamente e strumenti generativi impiegati per minacce o attività criminali.
Eviterei però una lettura apocalittica.
Questi casi non dimostrano che l'intelligenza artificiale stia “prendendo il controllo”.
Dimostrano qualcosa di più concreto e già misurabile:
stiamo aumentando rapidamente la capacità operativa delle macchine e delle persone che le utilizzano, mentre controlli, responsabilità e sistemi di supervisione devono evolvere alla stessa velocità.
È questo divario che considero oggi uno degli indicatori più importanti da monitorare.
Cosa monitorerò adesso sul caso #1693
Il caso spagnolo rimane la mia priorità per i prossimi aggiornamenti.
Cinque informazioni potrebbero cambiare significativamente la valutazione:
- identificazione del modello o dell'agente utilizzato;
- organizzazione colpita;
- tecnica di accesso iniziale;
- grado effettivo di autonomia nelle diverse fasi;
- conclusioni finali dell'AEPD.
Se emergesse che l'agente ha realmente adattato in autonomia la strategia di attacco dopo l'accesso iniziale, il caso avrebbe un valore molto maggiore rispetto a una semplice automazione di strumenti già esistenti.
La domanda da monitorare non è soltanto “l'AI è stata utilizzata?”, ma “quanta parte della decisione operativa è stata delegata all'agente?”.
FAQ — Agenti AI e incidenti reali
L'agente AI ha realmente condotto autonomamente un cyberattacco?
L'autorità spagnola ha reso pubblica una notifica nella quale l'attacco sarebbe stato eseguito mediante un agente AI e avrebbe incluso più fasi operative. L'AEPD sta ancora verificando la segnalazione, quindi il grado preciso di autonomia non è ancora noto.
Quale modello AI è stato utilizzato?
Il modello specifico non è stato identificato pubblicamente nel materiale disponibile.
Il caso significa che il produttore del modello è stato hackerato?
No. L'utilizzo di un modello o di un agente in un attacco non implica una compromissione del modello o dell'infrastruttura del suo produttore.
Gli otto incidenti sono tutti avvenuti a settembre 2026?
No. Sono otto nuove schede entrate nell'AI Incident Database, ma alcuni eventi risalgono al 2022, 2023 e 2024.
Qual è la differenza tra AI misuse e autonomia agentica?
Nel misuse una persona utilizza l'AI come strumento per raggiungere uno scopo dannoso. Nell'autonomia agentica il sistema può svolgere più passaggi, reagire ai risultati intermedi e proseguire con un livello maggiore di indipendenza operativa.
Qual è il rischio più importante emerso da questi casi?
Il rischio comune è l'aumento della capacità operativa: generazione, automazione, ricerca, adattamento e accesso a sistemi reali possono ridurre i costi e comprimere i tempi necessari per produrre conseguenze nel mondo reale.
Fonti principali
Questo articolo utilizza l'AI Incident Database come indice degli incidenti e distingue, ove possibile, tra fonte primaria, ricostruzione giornalistica e valutazione editoriale.
- AI Incident Database — database e schede più recenti
- AIID #1693 — AI Agent e data breach in Spagna
- Agencia Española de Protección de Datos — comunicazione sul caso agentico
- Reuters — verifica indipendente del caso spagnolo
- AIID #1691 — utilizzo di ChatGPT nella preparazione dell'attacco di Zurigo
- AIID #1692 — minacce di bomba generate con AI
- ABC News Australia — caso AI medical scribe #1695.
- WPEC / CBS12 — caso deepfake #1696.
- AI Incident Database — casi Flock Safety #1690, #1694 e #1697.
Questo articolo ha finalità informative ed educative. L'inserimento di un caso nell'AI Incident Database non dimostra automaticamente un rapporto causale tra un sistema AI e l'intero evento descritto. Alcune informazioni provengono da notifiche, accuse o procedimenti ancora in corso e vengono indicate come tali. Quando il grado di autonomia di un sistema non è noto, non viene trattato come fatto accertato. Le valutazioni su gravità, recidiva, contenibilità e rilevanza sistemica rappresentano analisi editoriali basate sulle informazioni disponibili al momento della pubblicazione.